


Веб-архив сайтов: как посмотреть старую версию и вернуть сайт


Время чтения: около 9 мин
Содержание
- Для чего нужен веб-архив сайтов и чего в нём нет
- Как открыть веб-архив и посмотреть старую версию сайта
- Как восстановить сайт из веб-архива: 7 шагов
- Где ещё искать данные, если снимков мало
- Если пропал и сервер: что собирать заново
- Как сохранить позиции после восстановления
- Чего веб-архив не вернёт
- Почему восстановления по архиву мало
- Частые вопросы
 Веб-архив возвращает публичную часть, а не весь сайт
| Что ищем | Где проверяем | Ограничение |
|---|---|---|
| Тексты, URL и оформление | Датированные снимки сайта | Сохранились не все страницы и файлы |
| Заказы, клиенты, остатки | Резервная копия, CRM или учётная система | Из публичных снимков эти данные не получить |
| Формы, поиск и личный кабинет | Исходники и рабочая CMS | Функции нужно восстановить и проверить отдельно |
Сначала составьте опись найденного. Срок и объём восстановления определяют после проверки источников.
Веб-архив сайтов — это публичная копия интернета: на web.archive.org можно открыть сайт таким, каким он был в любой сохранённый день, и по этим снимкам вернуть тексты, структуру и дизайн, если своих копий не осталось. Восстановление идёт так: снимки выгружают, собирают из них рабочую версию и публикуют по старым адресам. Если сайт пропал сегодня, сначала проверьте, что домен оплачен, и сохраните список адресов из веб-архива: как это сделать, показано ниже.
Вопрос стал практическим после сбоя Beget в ноябре 2026 года: если сервер утрачен, а своих копий нет, веб-архив часто остаётся главным источником текстов и структуры.
Для чего нужен веб-архив сайтов и чего в нём нет
Веб-архив нужен, чтобы увидеть сайт таким, каким он был в прошлом: проверить старые тексты, цены и структуру или вернуть контент после потери. Он хранит то, что видел посетитель: страницы, тексты, часть изображений, файлы оформления. Крупнейший публичный архив веб-страниц, Wayback Machine от Internet Archive, обходит интернет роботом и сохраняет их в виде снимков с датой. Серверную часть он не видит.
| Часть сайта | Есть в веб-архиве | Где брать, если нет |
|---|---|---|
| Тексты страниц и заголовки | Да, если страница попала в снимок | Яндекс Вебмастер, письма, документы компании |
| Изображения | Частично, крупные файлы часто пропущены | Компьютеры сотрудников, фотобанк, соцсети |
| Оформление (CSS и JavaScript) | Обычно да | Репозиторий разработчика, тема сайта |
| База данных, заказы, пользователи | Нет | Только резервная копия или выгрузки из CRM |
| Программный код, админка, формы | Нет | Исходники у разработчика или новая сборка |
| Закрытые разделы и личный кабинет | Нет | Резервная копия |
Отсюда главное ограничение: из веб-архива возвращается внешний вид и контент, но не «движок» сайта. Каталог, корзина, поиск и формы потребуют пересборки.
Как открыть веб-архив и посмотреть старую версию сайта
Старую версию сайта смотрят на web.archive.org, который в поиске часто называют «веб-архив орг». В строку поиска вводят домен и открывают календарь снимков: каждая отмеченная дата означает, что робот сохранил страницу в этот день.
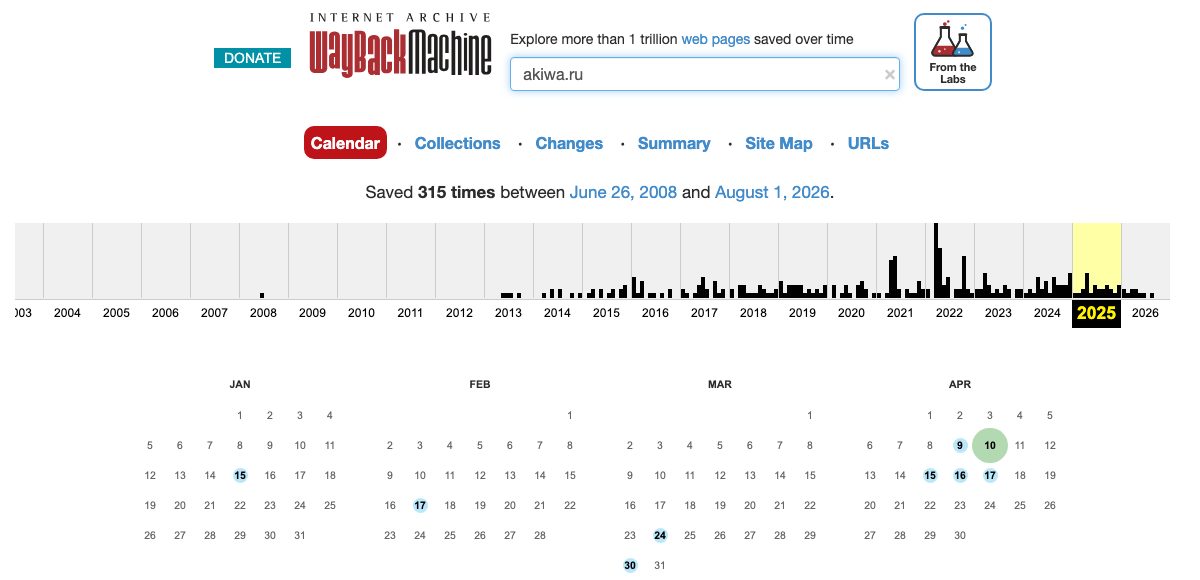
- Откройте web.archive.org и введите адрес сайта, например akiwa.ru.
- Выберите год на шкале и день в календаре. Сравните несколько снимков до сбоя: ближайший по дате не обязательно самый полный.
- Пройдите по внутренним ссылкам: архив подставит ближайшие по дате снимки других страниц.
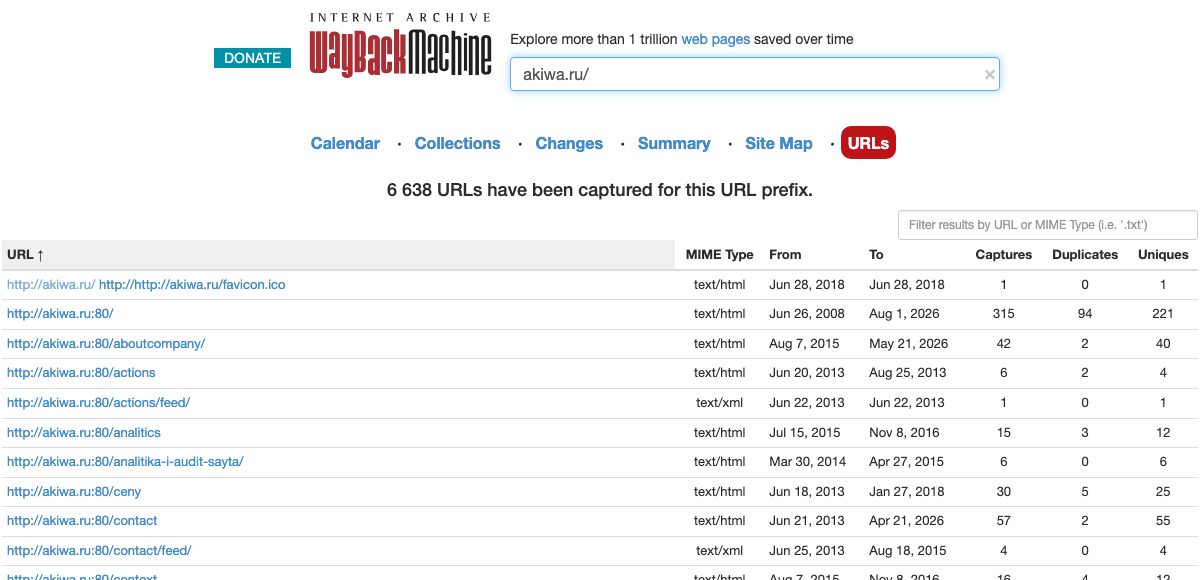
- Получите список всех сохранённых адресов: введите домен со звёздочкой в конце, например «site.ru/*», или откройте вкладку URLs. Архив покажет таблицу с датами первого и последнего снимка.
- Сохраните этот список в таблицу. Он станет картой сайта для восстановления и проверки позиций.
Так же можно найти удалённый сайт и посмотреть его, даже если домен уже не открывается: страницы остаются в архиве после удаления аккаунта на хостинге. Для поиска достаточно помнить домен. Если домен забыт, ищите его в старых письмах, счетах, визитках и в поисковой выдаче по названию компании.
Если снимков нет, домен мог быть закрыт от робота в robots.txt или по запросу владельца. Тогда переходите к другим источникам: они перечислены в разделе «Где ещё искать данные».
Как восстановить сайт из веб-архива: 7 шагов
Восстановление сайта из архива занимает от одного дня для визитки до нескольких недель для каталога. Срок зависит от числа страниц и того, сколько из них архив сохранил. Шаги с пометкой «сами» проходит владелец, шаги «с разработчиком» требуют технического специалиста.
- Соберите список страниц. сами Сведите в одну таблицу адреса из веб-архива, Яндекс Вебмастера, Google Search Console и рекламных кампаний.
- Выберите дату снимка. сами Берите последний полный снимок до сбоя. Для разных разделов допустимы разные даты.
- Выгрузите файлы. с разработчиком Для десятков страниц хватит ручного сохранения. Для сотен используют утилиты вроде wayback-machine-downloader или сервисы вроде Archivarix: они скачивают HTML-код и вложенные файлы пакетом.
- Очистите код. с разработчиком Удалите служебную панель архива, переписанные ссылки вида web.archive.org/web/… и битые счётчики.
- Решите, куда переносить. сами Статическая копия, то есть набор готовых страниц без админки, подходит для визитки и лендинга. Для каталога, блога и форм контент переносят в систему управления (CMS): WordPress, 1С-Битрикс или ту, что была раньше.
- Верните адреса. с разработчиком Каждая страница должна открыться по прежнему адресу. Если он изменился, настройте 301-редирект, то есть постоянную переадресацию со старого на новый.
- Проверьте и опубликуйте. с разработчиком Откройте сайт через файл hosts до переключения DNS, так новая версия видна только вам. Проверьте формы, мобильную версию, robots.txt и sitemap.xml.
Если на старом хостинге остался архив файлов, а база данных пропала, комбинируйте: шаблон и картинки берите из архива хостинга, тексты из веб-архива.
Где ещё искать данные, если снимков мало
Веб-архив редко сохраняет всё, поэтому его дополняют другими источниками. Проверьте шесть мест:
- Резервные копии у прежнего разработчика, на рабочих компьютерах и в облачных дисках сотрудников.
- Файловые копии хостинга: запросите их у провайдера, даже если сервер пока недоступен.
- Яндекс Вебмастер и Google Search Console: списки страниц в поиске, заголовки и описания.
- Почта и мессенджеры: макеты, тексты для страниц, прайс-листы в PDF.
- Соцсети и карточки на площадках: фото товаров, описания, отзывы.
- Выгрузки из CRM, 1С и сервисов рассылок: товары, цены, клиенты.
Регулярный бэкап сайта снимает эту проблему заранее: с ним восстановление занимает часы, а не недели поиска по архивам. Но выручает только бэкап, который хранится отдельно от хостинга и уже проверен восстановлением.
Если пропал и сервер: что собирать заново
Если сервер утрачен, как VPS на Beget, а файловой копии хостинга нет, под рукой нет ни исходного кода, ни базы данных. Тогда всё собирают на новом месте в два слоя: контент из архивов, функции заново.
- Тексты, структуру и мета-теги переносят из веб-архива.
- Дизайн воспроизводят по снимкам: оформление часто сохраняется, и вёрстка повторяется близко к оригиналу.
- Каталог товаров собирают из выгрузок 1С, маркетплейсов или прайс-листов.
- Формы, корзину и личный кабинет подключают в новой CMS.
Отдельно о серверах: что делать, если утрачен VPS на Beget, и чего без копий не вернуть, мы разобрали на странице восстановления сайта.
Как сохранить позиции после восстановления
Прежние адреса и полезный контент помогают поисковикам сопоставить восстановленные страницы с прежними, но не гарантируют сохранение позиций. Пока сайт лежит, Яндекс и Google видят ошибки и через какое-то время начинают исключать страницы из индекса, поэтому скорость возврата важна.
- Сохраните прежние адреса страниц, заголовки title и H1, описания description.
- Настройте 301-редиректы для адресов, которые поменялись.
- Обновите sitemap.xml и отправьте его в Яндекс Вебмастер и Google Search Console.
- Через 2–4 недели сверьте число страниц в поиске со списком, который собрали на первом шаге восстановления.
Если сайт возвращается на другой сервер, пройдите чек-лист из статьи как перенести сайт на другой хостинг: там описаны проверка через hosts и переключение DNS.
Чего веб-архив не вернёт
Веб-архив не вернёт данные, которые не были публичными страницами. Сюда относятся:
- заказы, регистрации пользователей и история переписки;
- пароли, настройки CMS и интеграции с оплатой и доставкой;
- страницы, которые робот не посещал или посещал с ошибкой;
- большие изображения, видео и файлы для скачивания, если их не сохранили отдельно.
Эти данные возвращаются только из резервной копии или внешних систем. Если их нет, честнее заново настроить функции, чем обещать клиентам полный возврат.
Почему восстановления по архиву мало
Сборка по снимкам занимает от дня до нескольких недель, и всё это время сайт не принимает заявки. Лучше сделать так, чтобы до архива дело не доходило. Для этого бэкап лежит в двух независимых хранилищах, а не только у хостинга, домен переключается на другую площадку без участия провайдера, а развёртывание проверяют заранее. Тогда после аварии сайт возвращают за часы, а не неделями по снимкам.
АКИВА ведёт такую защиту под ключ: отслеживаем работу сайта, делаем копии и проверяем их, проверяем восстановление по согласованному графику и показываем результат. Если вернуть сайт нужно уже сейчас, ищем снимки и другие источники, собираем его и заранее честно говорим, чего вернуть не получится. Состав работ описан на странице восстановление сайта после сбоя хостинга.
Чтобы при следующем сбое не собирать контент по снимкам, настройте независимое резервное копирование сайта и базы данных. В разделе безопасности сайтов можно сравнить этот сценарий с восстановлением уже недоступного сайта.
Если утрачен и виртуальный сервер, одной выгрузки страниц недостаточно. Разберите, что проверить при потере VPS на Beget: отдельно понадобятся данные, настройки окружения и проверка функций.
Частые вопросы
Можно ли восстановить сайт из архива бесплатно?
Да, если страниц немного. Просмотр Wayback Machine бесплатный, ручное сохранение и открытые утилиты тоже. Платными бывают сервисы пакетной выгрузки и сама сборка.
Сколько страниц сохраняет веб-архив?
Это зависит от сайта. Популярные страницы робот посещает чаще, глубокие разделы каталога может не сохранить ни разу. Точное число видно в списке адресов по запросу «домен/*».
Вернётся ли база данных интернет-магазина?
Нет. Веб-архив хранит только публичные страницы. Товары можно восстановить по карточкам каталога, но заказы, клиенты и остатки возвращаются лишь из бэкапа или выгрузок 1С и CRM.
Не накажут ли поисковики за восстановленный контент?
Как правило, нет, если это ваш собственный контент на вашем домене: поисковики увидят те же тексты по тем же адресам. Проблемы возникают, когда контент чужой или публикуется на другом домене без 301-редиректа.
Что делать, если сайта нет в Wayback Machine?
Ищите другие источники: файловые копии хостинга, Яндекс Вебмастер, почту, соцсети, компьютеры сотрудников. Если контента не осталось совсем, сайт создают заново с прежней структурой адресов.
Читайте также
Оформить подписку


